測試環境的記帳本有 46 筆帳目,其中 31 筆沒有分類,占 67%。
第一個念頭是怪關鍵字表太小。記帳最省的講法是 記帳 午餐 120 這種固定格式,它不經過模型,分類只能靠一張關鍵字表從項目名稱猜,表漏了就是未分類。但把那段期間的記帳輪次攤開看,走模型的有 33 輪,走捷徑的只有 9 輪。未分類的絕大多數,是模型已經參與、卻仍然留空。
模型為什麼一律留空
分類欄位的描述原本只有一句:「選填。判斷不出來就省略,不要硬選一個。」用正式的工具 schema 實測十句常見項目,像綠茶、啤酒、春捲、餅乾、帽子,模型每一句都回空值。
這句話本意是防止亂猜,效果卻是讓模型把「省略」當成最安全的選項。換成積極的版本,逐一列出每個分類涵蓋什麼、明講「盡量填」、只有完全看不出來才省略,重測 15 句命中 14 句,「物品A」這種沒有語意的名稱仍然正確留空。
這段字不是說明文件,它就是分類品質本身。所以我們用測試釘住「每一個分類值都要在描述裡交代」:新增一個分類卻忘了寫進描述,等於加了一個模型永遠不會選的值,而這種缺陷是靜默的,沒有任何測試會因為「某個值從來沒被選過」而變紅。
剩下的缺口在捷徑
模型這條路修好之後,才輪到捷徑。我們拿 35 個常見講法試關鍵字表:猜得到 11 個,猜不到 24 個。牛排、義大利麵、韓式烤肉、連鎖店的店名,一個都不在表裡。同樣這幾句話不加「記帳」兩個字,走自由句型交給模型,全部分對。
落差只有一個來源:捷徑不經過模型。
看起來只有兩個做法:
- 一直補關鍵字表。追不上。真實的講法沒有盡頭,每一個新店名都是新的洞。
- 捷徑改走完整的模型輪次。分類會對,但一輪約 2,900 tokens,而且使用說明寫著這個格式「不消耗 AI 對話額度」,那是對外的承諾。
不過 0 和 2,900 之間不是只有這兩個選項。捷徑貴的不是「呼叫模型」,是一輪對話的固定開銷:系統提示詞,加上這一輪載入的全部工具 schema,這部分占了一輪成本的絕大多數。只替一個項目名稱分類,不需要那些。
三層:每一層只處理上一層漏掉的
| 層 | 成本 |
|---|---|
| 1. 關鍵字表 | 0 |
| 2. 快取 | 0(0.2 ms) |
| 3. 極小呼叫 | 194 tokens、約 600 ms |
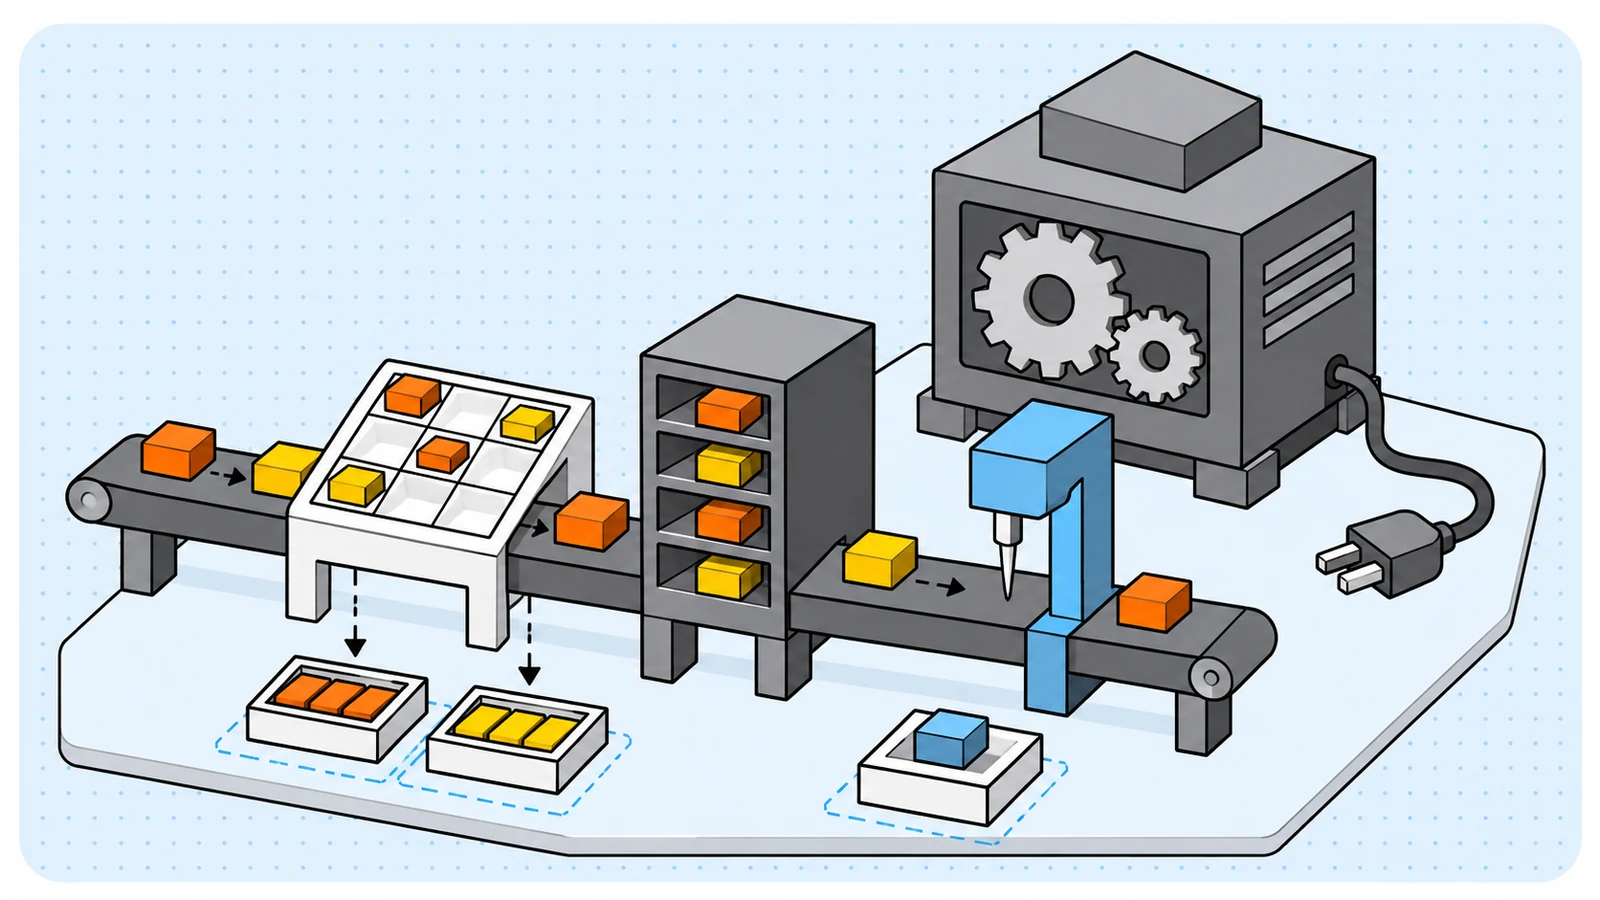
第一層是午餐、捷運、咖啡這類最高頻的詞;第二層是之前有人問過的項目,實測命中時整條路徑只要 0.2 ms;第三層是只做分類的極小呼叫,只處理真的第一次見到的項目。
第三層只送一個項目名稱,系統指示只講分類規則,輸出限定在固定的十三個值:十二個分類,加上一個「認不出來」。194 tokens 約是一輪完整記帳對話的 6%,而且前兩層都沒中才會走到。
這個設計押在一個推論上:記帳是習慣性動作,一個人的項目詞彙很小而且高度重複,所以穩態下第三層應該很少被打到。這是設計時的推論,不是量出來的,後面「上線一個半月後回頭看」會講能驗證多少。
快取:共用知識,不存身分
第二層的快取有幾個決定,每一個都擋掉過一種失效:
- 全域共用,不是每人一份。「牛排 → 飲食」對每個人都是同一個答案,項目名稱不帶身分。key 空間小一個量級(Redis 還要跟配額計數器與對話記憶共用),而且第一個人付費,其他人免費。
- key 要帶「支出或收入」。同一個詞的答案會不同:「房租」當支出是居住,當收入(房東收租)是投資。
- 「認不出來」也要記。用一個哨兵值記下「問過了,模型也認不出來」。不然「物品A」這種永遠分不出來的名稱會每次都重打一次模型,那正是最沒有價值的一種呼叫。
- 正規化只做去空白與統一大小寫。不去中間的空白、不去標點。「手搖飲店名 大杯」和「手搖飲店名」是不是同一個東西,我們並不知道,寧可多打一次。
- 太長的不快取,其餘存 30 天。超過 40 個字多半是整句話被當成項目。保存期限不設永久,讓不再出現的詞自己消失,而不是靠人記得去清。
- 快取操作自己要有 0.5 秒上限。Redis 客戶端預設沒有逾時,連線卡住時會無限等。這條路徑的前提是「分類不能拖累記帳」,Redis 抖一下就比它要防的 4 秒模型逾時還糟。
最後一條值得多看一眼:保護加值路徑的那道防線,自己也可能變成拖累它的原因。
少了上下文的模型更敢猜
第一版分類器指示只寫「完全看不出來就回 none」。結果「物品A」被猜成購物,「雜項」被猜成其他,而完整輪次那條路徑,兩個都正確留空。
差別在上下文:完整輪次的模型看過使用者整句話,極小呼叫只看得到一個名稱。修法是把該放棄的情況直接舉例寫進指示:「物品A」「雜項」「東西」「項目1」這種沒有語意的佔位名稱一律回 none。調完 17 題全對。
這也是為什麼只有捷徑會走第三層。自由句型的模型看過整句話才決定留空,拿一個只看得到名稱的呼叫去覆蓋它,是用比較差的資訊推翻比較好的。
有了保底之後,關鍵字表的角色變了
第三層上線前,關鍵字表是正確性機制:不收這個詞,使用者的帳就沒有分類。上線後它變成純粹的成本優化,只負責省掉最高頻那批項目的極小呼叫。收詞的判準跟著換:看的是「它多常出現」,不是「不收就會漏」,因為不收只是多付一次 194 tokens,而且只付一次。
不變的是兩條:
- 只收沒有第二種解讀的詞。「超商」不收,因為在那裡買的一半是飲料、一半是日用品。
- 看不出來就留空。亂猜會讓使用者以為系統懂他,月底看統計時被誤導,那比留空糟得多。
比對採「長關鍵字優先」,因為子字串會互咬:「飯店」會被「飯」吃成飲食,「藥妝」會被「藥」吃成醫療。
加值路徑的三條底線
分類是加值,帳目寫得進去才是這個功能。第三層因此有三條不能破的線:
- 一定要 fail-open。任何例外、4 秒逾時、模型吐了認不得的值,一律當成「沒有分類」。使用者只是想記一筆咖啡,不能因為分類出錯而記不成。
- 不計入使用者的額度。使用說明對外承諾了,成本由我們吸收。那一輪對使用者仍然是 0,用量照樣記進我們自己的用量表,只是不扣他的額度。
- 遙測只記分類值,不記項目名稱。項目名稱是使用者打的字,log 只放筆數與分類的 enum 值。
遙測的存在,是為了分辨前面那兩種「未分類」:模型沒填,還是表沒猜到。這兩者的修法完全不同,而只看未分類的總數分不出來。所以每次寫入都記一行:模型填了幾筆、關鍵字補了幾筆、極小呼叫補了幾筆、仍然沒分類幾筆。
這一行上線當天就踩到監控那篇講的那類失效。我們在正式站測了五筆,全部分類正確,log 和 Loki 卻一行都查不到:這兩行是 INFO,而正式站的 log 層級是 WARNING,整個被濾掉了。加遙測的唯一目的就是讓它在正式站看得見,濾掉等於白做。修法是給它自己的 logger,掛進「永遠保持 INFO」的名單,而且刻意只放行這個子 logger,不放行整個模組,因為那裡還有逐工具呼叫的 INFO,正是要壓掉的東西。
上線一個半月後回頭看
第三層與快取在 2026-09-10 上了正式站。以下是 09-12 到 10-27 的遙測,排除部署後自動測試產生的輪次,能驗證的和不能驗證的要分開講:
- 一輪完整記帳對話的成本:量得到。平均約 2,900 tokens,和設計時拿來比的數字相符,「極小呼叫約是整輪的 6%」這個比例成立。
- 捷徑占多少:量得到。約 6% 的記帳輪次走捷徑,其餘都是自由句型。
- 各層各命中多少:沒有資料。用量表 10 月 1 日才開始記;「哪一層命中」只存在 INFO log,而運作日誌依隱私政策只保存 14 天。
- 最後有多少帳目沒分類:只能當量級看。09-11 之後寫入的帳目約 13% 沒有分類,含刻意留空的佔位名稱。樣本不大,也不能拿去跟前面測試環境的 67% 比。
所以「穩態下幾乎不花錢」到現在仍是推論,不是量到的事實。我們確定的是成本的上界:每個新詞在快取的 30 天內最多付一次 194 tokens,失敗也不影響記帳。平均成本是由流量決定的,而在這個功能的流量下,捷徑只占一小部分,第三層更像保險,不是省錢。
這是這次最該帶走的一課:成本優化之前,先量入口的占比;證據要放在比 log 活得久的地方。如果當初把命中率每天彙總進資料表,現在就能回答「這一層到底有沒有用」。放在 14 天會被刪掉的 log 裡,我們只能回答「它的上界是多少」。
可以帶走的原則
- 「未分類很多」先問是誰沒填:模型沒填、表沒猜到、還是被後處理丟掉。修法完全不同,遙測要能分辨來源。
- 描述 enum 的那段提示詞就是品質本身。每新增一個值,要有測試釘住描述有交代到。
- 不經過模型,不等於只能 0 token。把固定開銷和呼叫本身分開算,中間還有「只做一件事的極小呼叫」。
- 便宜的層擋大多數,貴的層只處理剩下的,每一層的命中條件要講得清楚。想看同一個母題在按鈕上的做法,見按鈕不該再讓模型理解一次。
- 快取共用知識,不存身分;key 要包含會改變答案的維度;「問過了認不出來」也要記。
- 保護加值路徑的防線,上限要比它保護的對象更嚴(快取 0.5 秒,模型 4 秒),而且一律 fail-open。
- 少了上下文的呼叫更敢猜:把該放棄的情況舉例寫進指示,也別用它去覆蓋有完整上下文的判斷。
- 有了更貴但更準的保底之後,便宜那層的角色從「正確性」變成「成本」,收詞的判準也要跟著換。
- 對外承諾的額度規則要守住:成本由我們吸收,不能偷偷扣到使用者頭上。
- 優化要留得住證據。指標放在比 log 保存期更長的地方,否則半年後沒有人能回答它有沒有用。