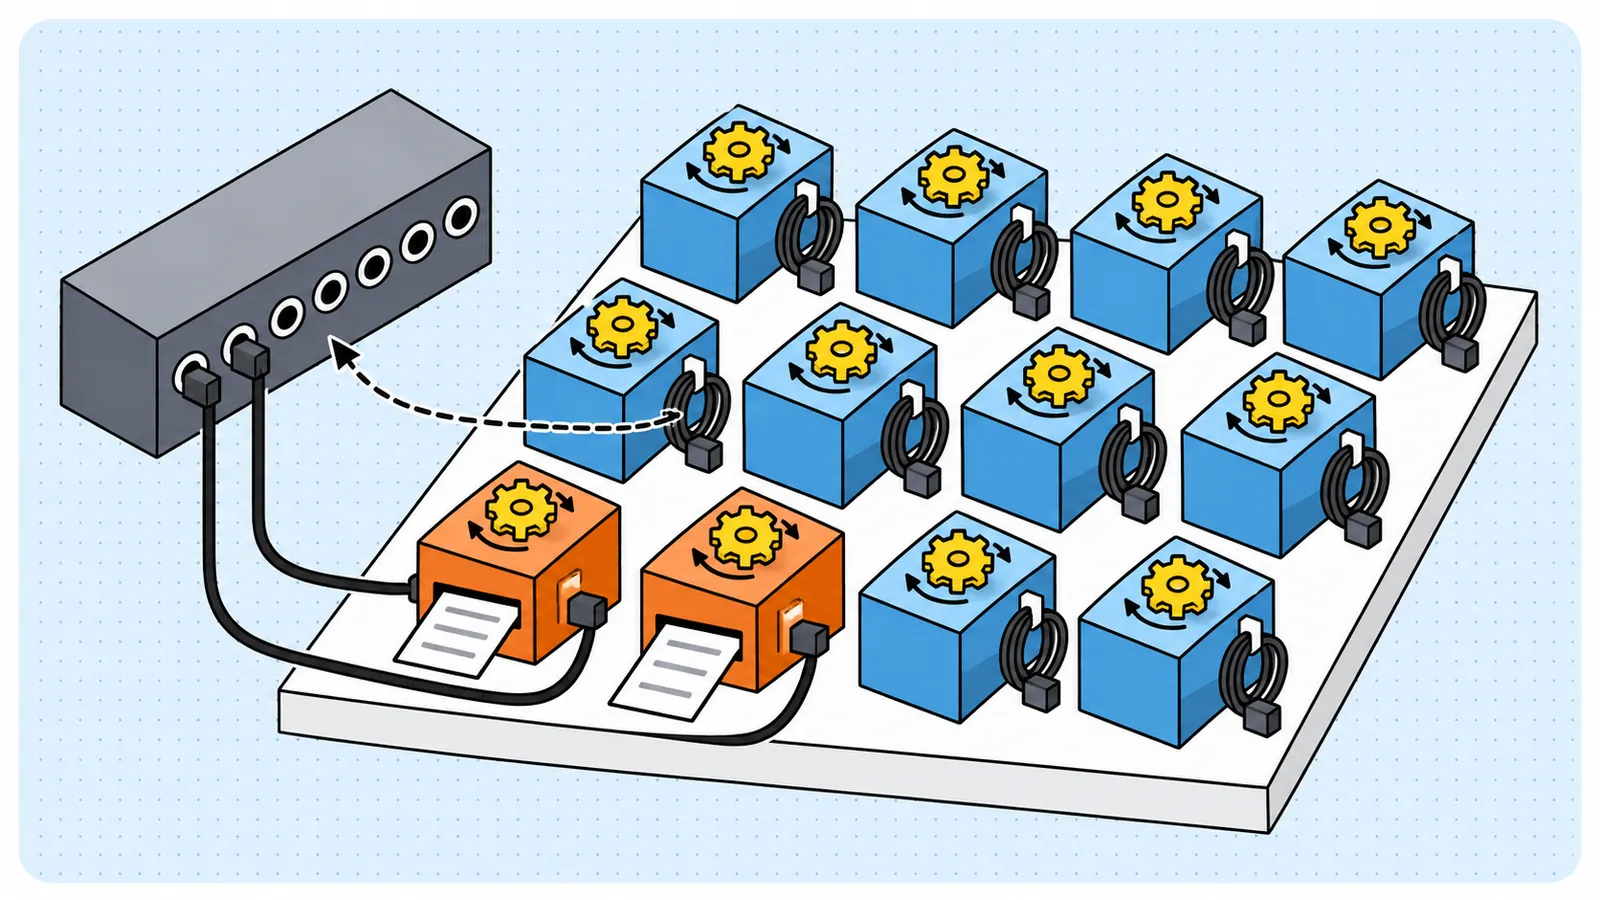
瓶頸是連線池,不是語言:模型在回答時別握著資料庫連線
AI 客服的 CPU 只忙了 8%,卻拒絕了幾乎所有同時發問的人。問題不在程式語言,而在一輪對話從頭到尾握著同一條資料庫連線。本文整理怎麼用假模型零成本量出天花板、在每次呼叫模型前把連線還回去,以及付過錢之後為什麼反而要耐心等。
Twincoal 的技術文章:從真實產品出發,記下 AI、架構、測試與部署中值得被重複使用的判斷。
AI 客服的 CPU 只忙了 8%,卻拒絕了幾乎所有同時發問的人。問題不在程式語言,而在一輪對話從頭到尾握著同一條資料庫連線。本文整理怎麼用假模型零成本量出天花板、在每次呼叫模型前把連線還回去,以及付過錢之後為什麼反而要耐心等。
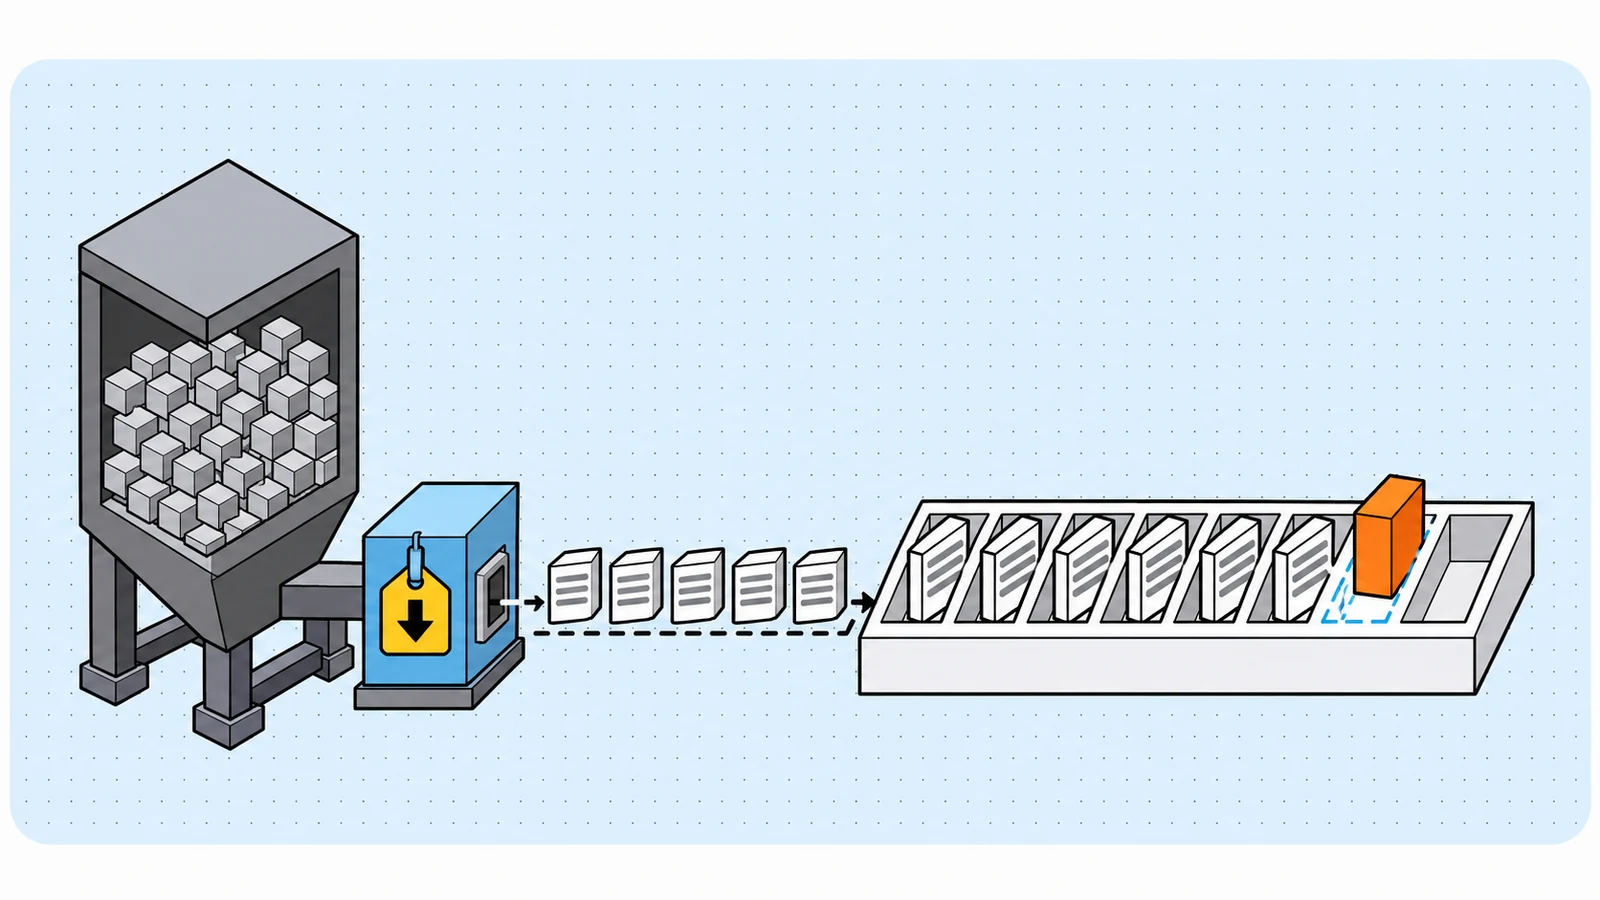
使用者看不懂 token,擋門文案卻只能講額度。本文整理怎麼用正式站遙測校準出「每則約 2,350 加 250 乘記憶輪數」,取整為什麼要不對稱,以及兩份公式怎麼防止悄悄漂開。
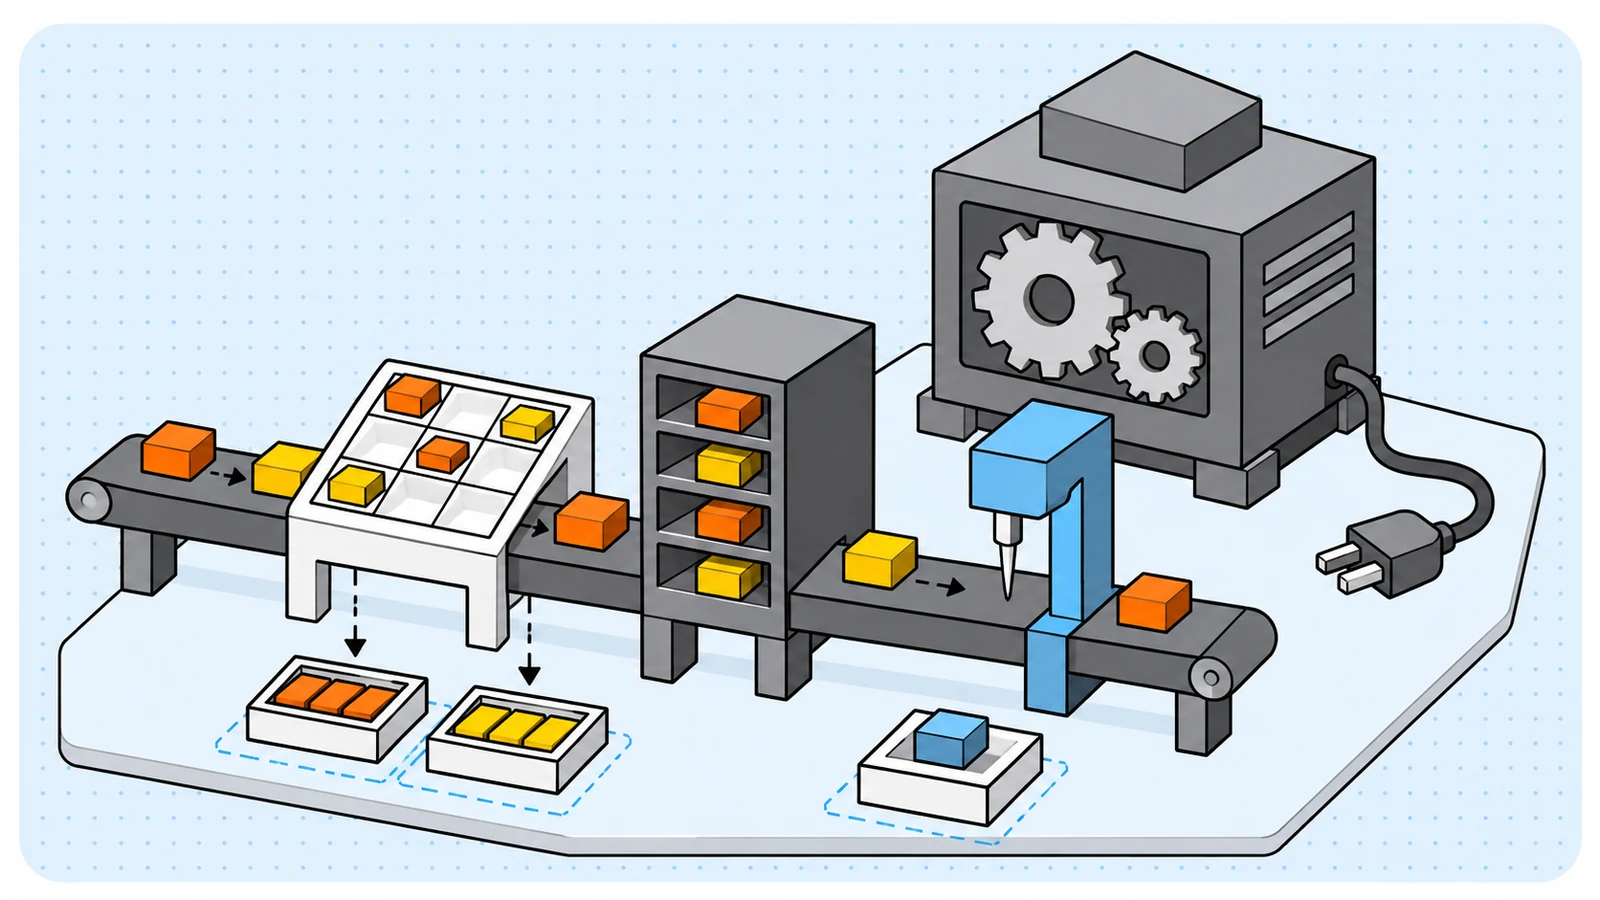
記帳捷徑不經過模型,分類只能查關鍵字表,35 個常見講法漏了 24 個。補洞不必退回整輪對話:先查表、再查快取、最後才打一次 194 tokens 的極小呼叫。本文整理三層怎麼分工,以及上線後能驗證與不能驗證的。
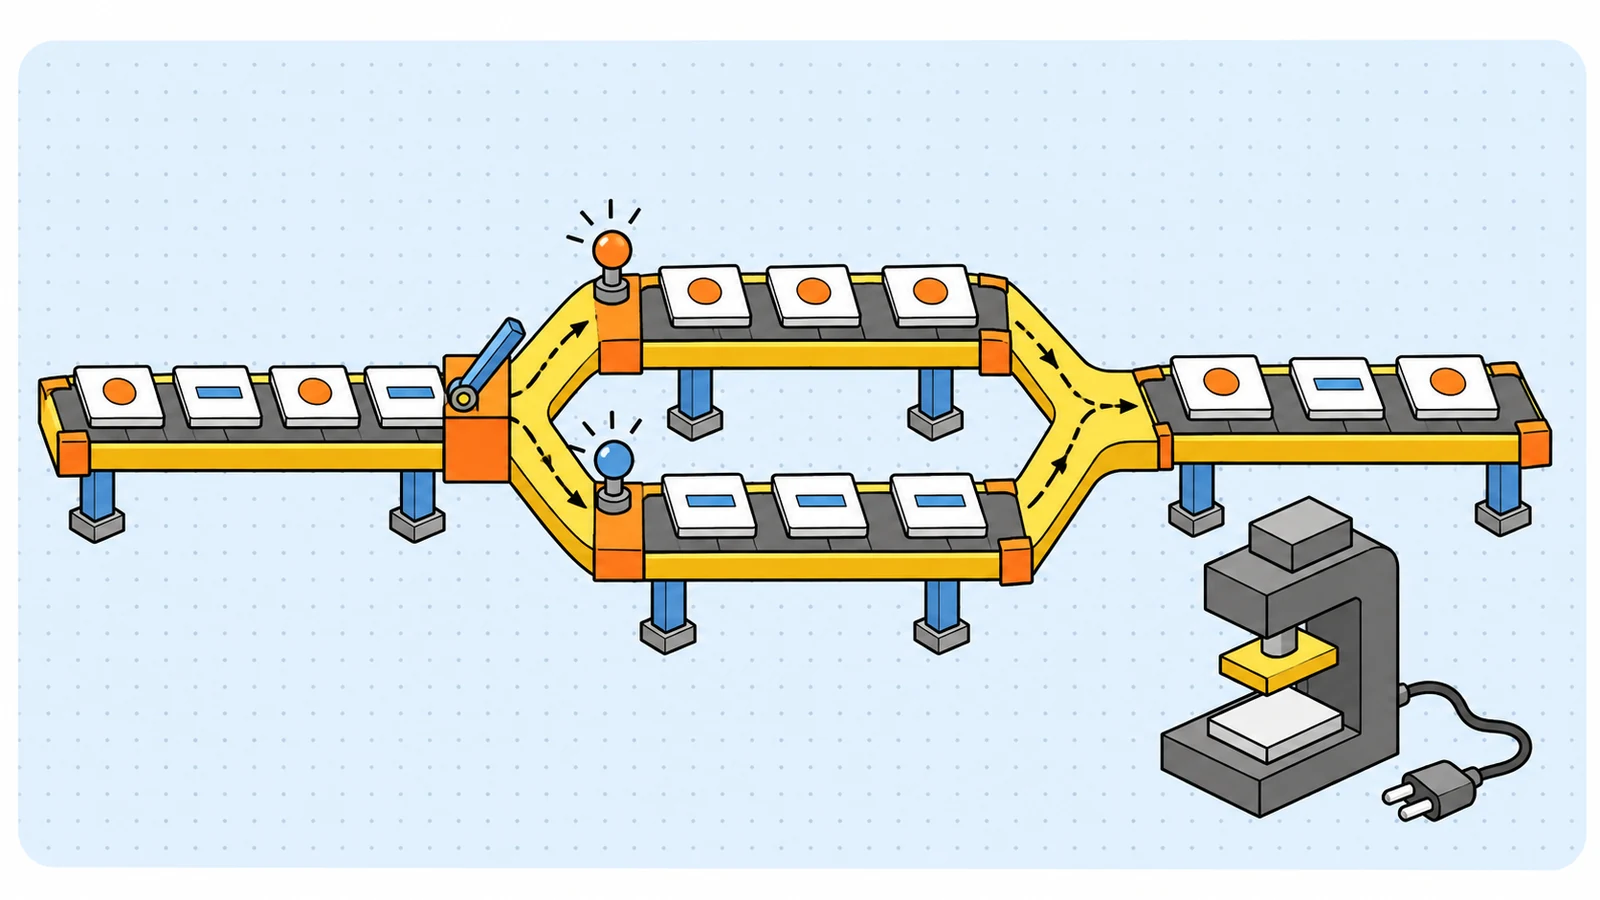
拒答標記只在例外時才要求,換了模型就有一半正確的拒答沒宣告,改措辭兩輪都量不出進步。把任務改成每則回覆第一行二選一,兩個模型都是 30/30。本文整理怎麼讀出原因、怎麼便宜地迭代。
同一個 Claude 模型,在知識庫問答上贏過現行模型,在帶工具的 LINE 對話上卻第一關就被淘汰。本文整理事先寫下的決策規則、為什麼打平就不換,以及延遲與 token 單位怎麼左右結論。
一次全面健檢沒有找到任何可利用的漏洞,真正的問題是沒有人在看,以及一整排不會失敗的檢查。本文整理監控看起來存在、實際上不生效的六種形狀,以及各自怎麼驗。
把前幾輪對話摺進檢索查詢,看起來只是給一點線索,實際上是讓前一題的主題跟這一題搶同一個向量。本文整理正式站量到的兩個案例、修法,以及為什麼相似度門檻救不了這件事。
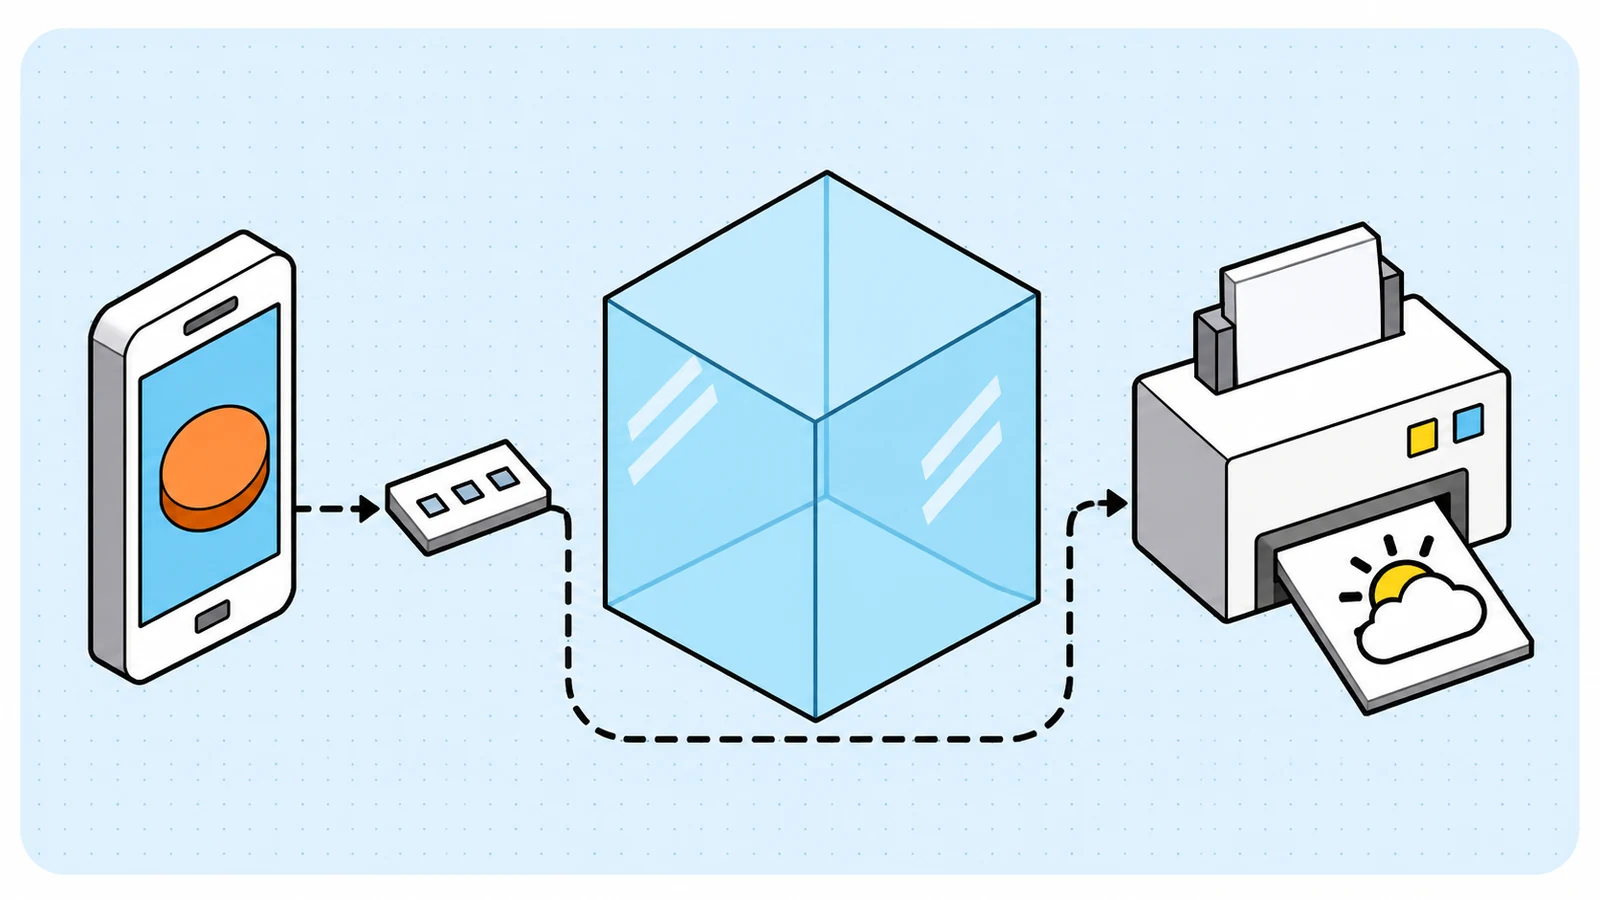
意圖按鈕送出的那句話是我們自己寫的,卻每按一次就付幾千個 token 請模型再讀懂一次,有時還讀錯。本文整理改走 postback、由程式直接執行並組卡片之後,哪些事要自己補回來,以及上線後量到的數字。
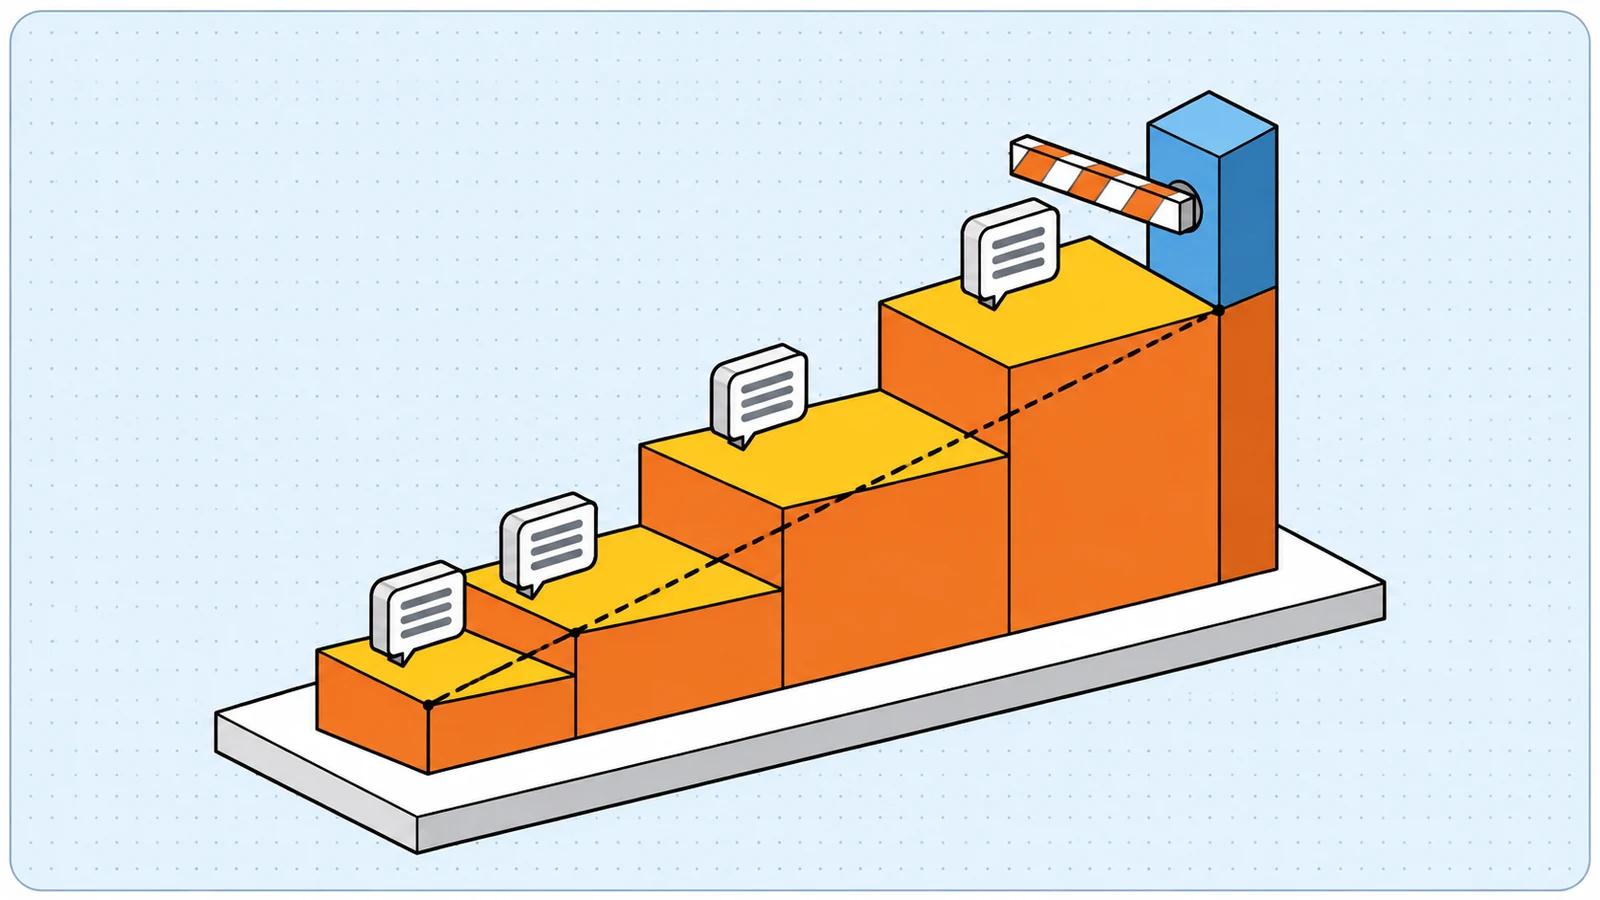
跨過訊息額度的那一階,斷的不是慢郎中的訊息,是整個月、連付費會員一起斷。這篇整理怎麼從實測資料決定門檻、怎麼設計一個上線第一天就不能誤傷任何人的狀態機,以及一次真實的資料回填事故。
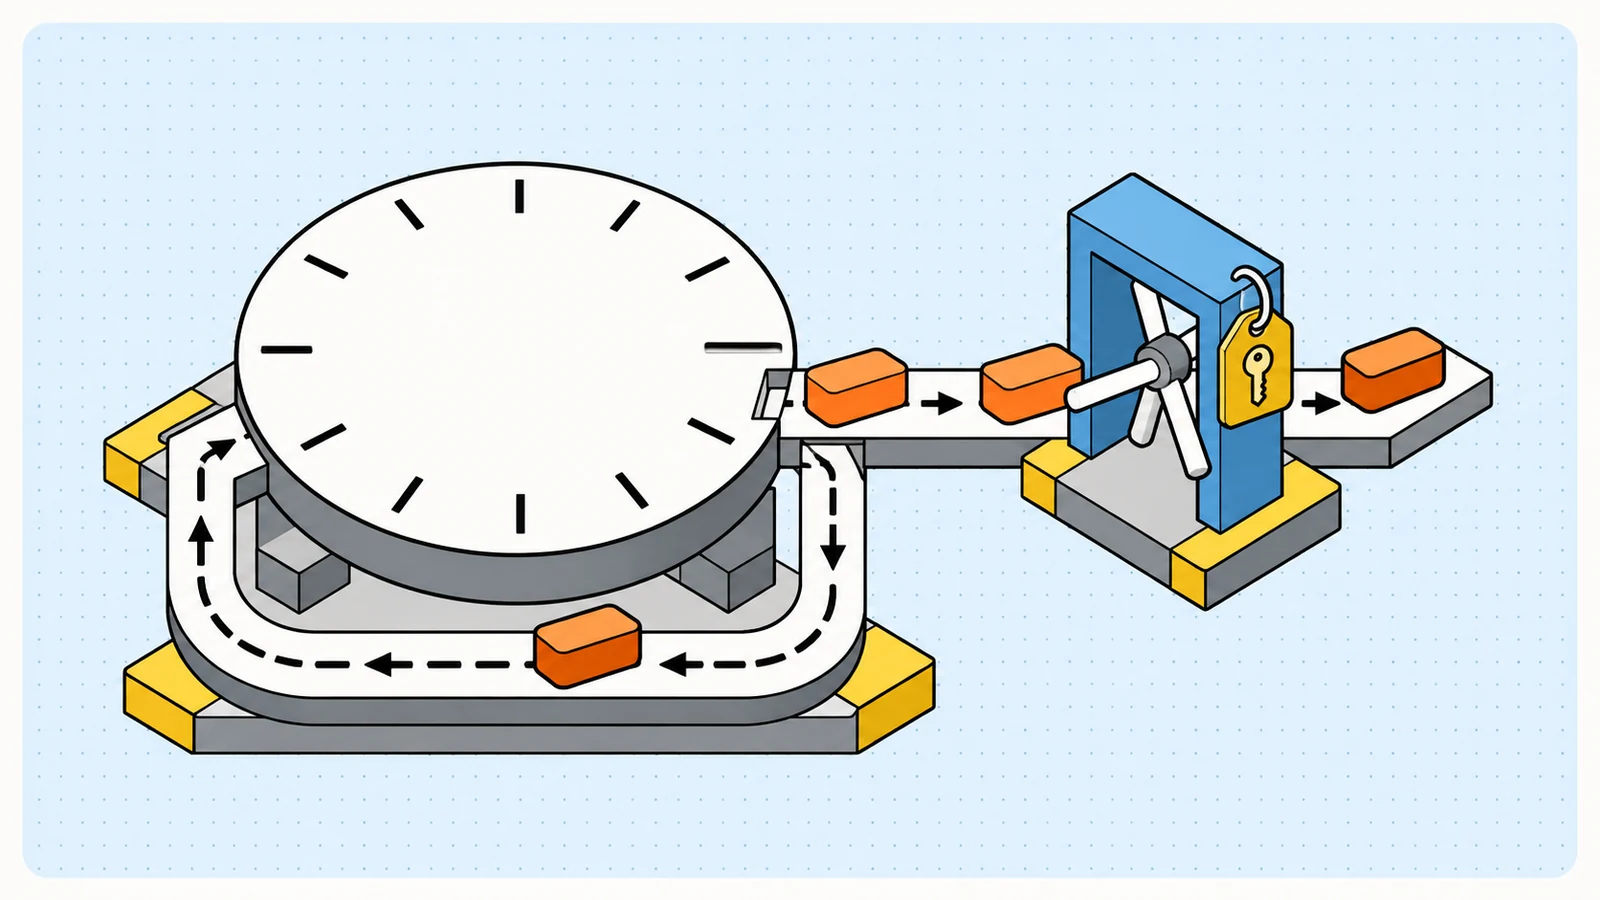
上游每個資料源都有重試,最後一哩卻沒有。本文從排程語意反推重試該在何時完成、哪些錯誤值得重送,以及冪等鍵如何在不打擾任何人的前提下驗證。
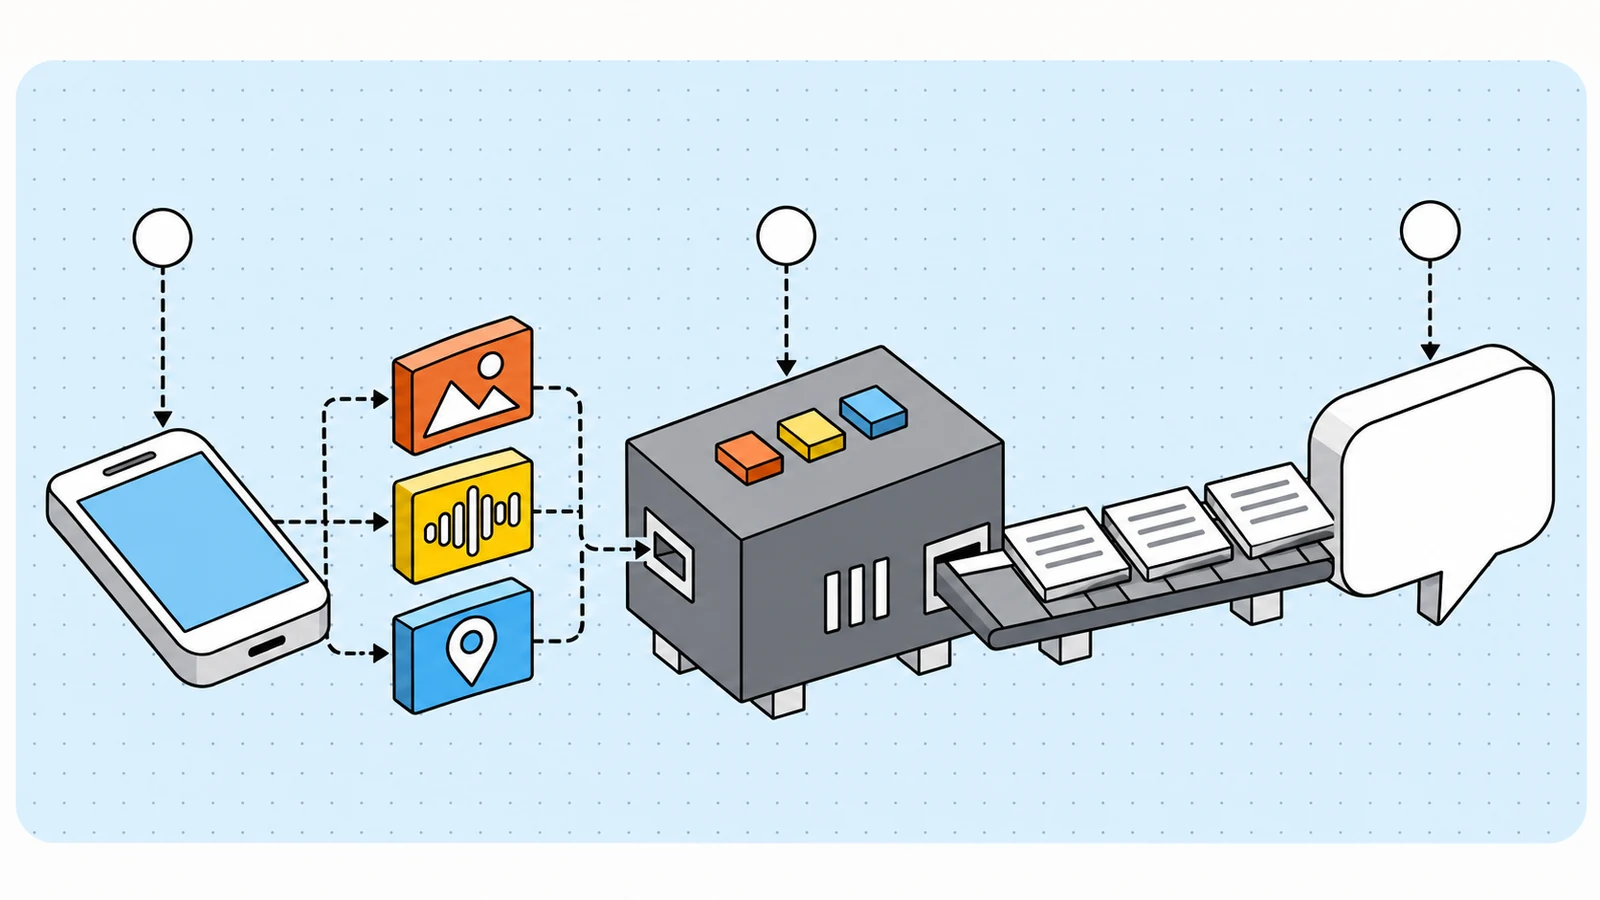
照片、語音與位置進入 LINE Bot 後,不一定要直接送進大型語言模型。本文拆解先轉文字再進對話管線的設計與取捨。
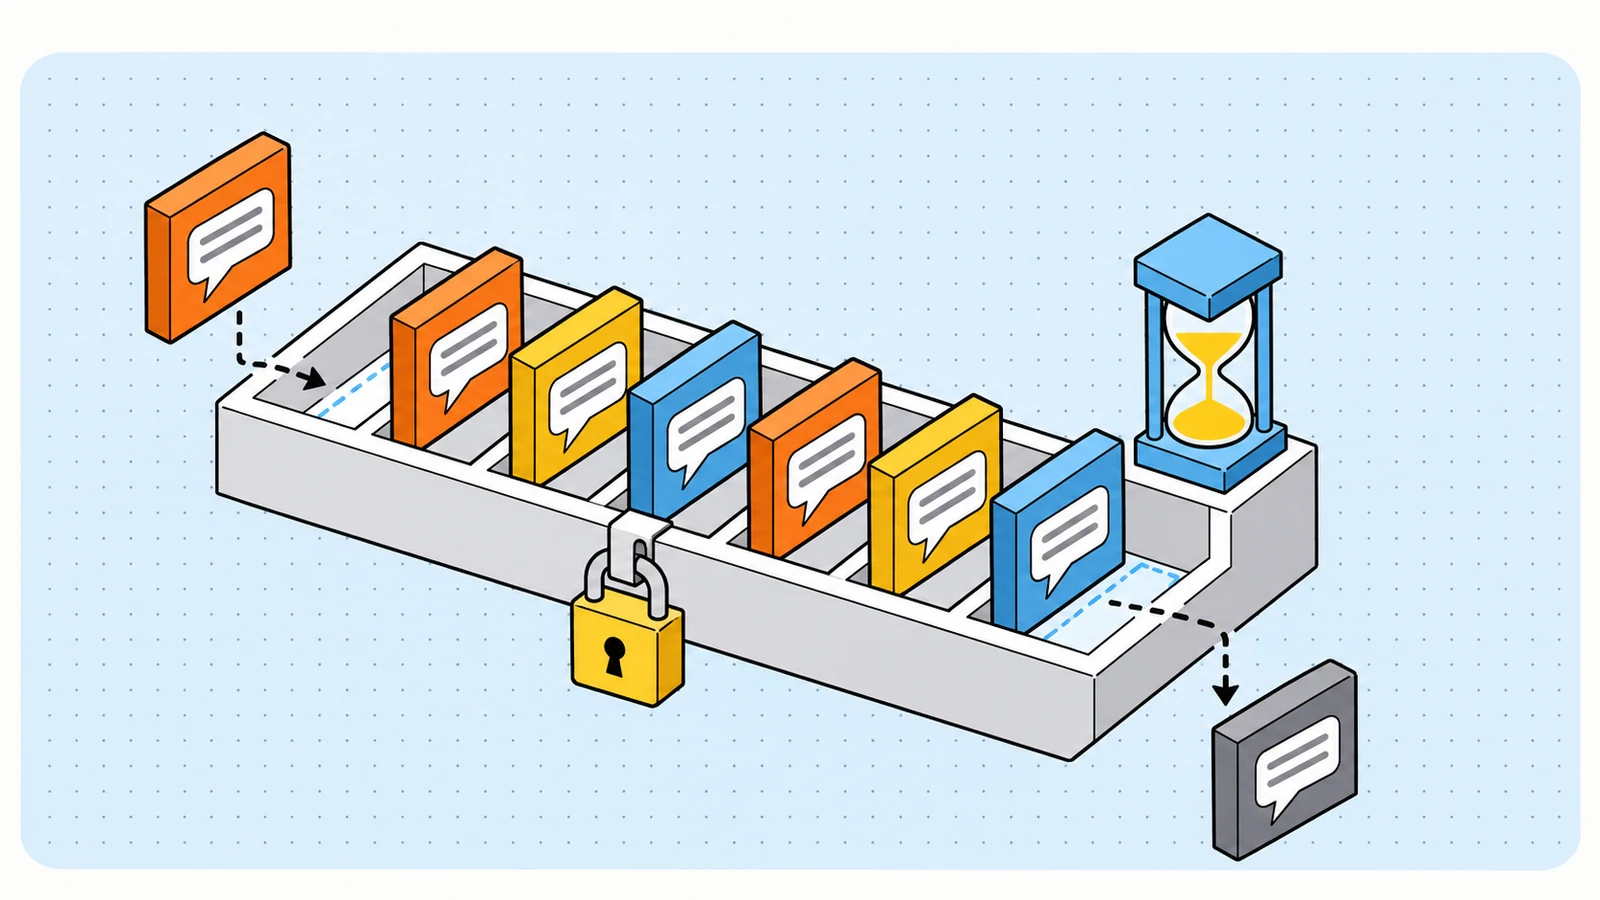
短期對話記憶不只是把訊息存進 Redis。本文整理 TTL 邊界、fail-open、字元上限與工具摘要如何共同控制隱私和成本。
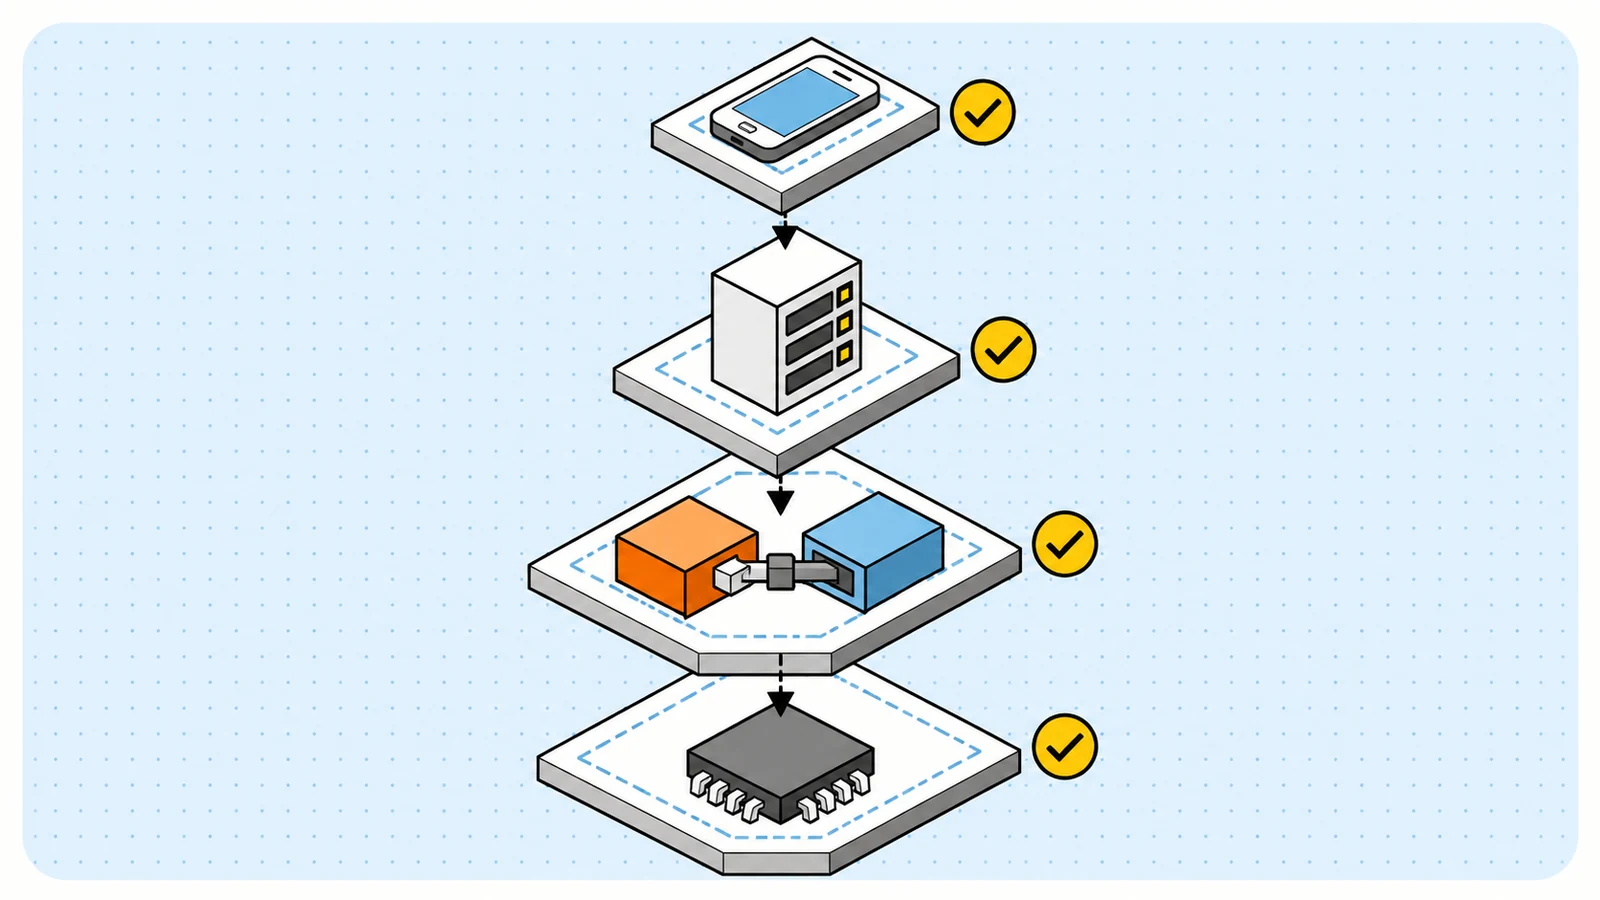
從單元測試、跨服務契約、部署後 smoke 到真實模型行為,如何依環境變異與失敗代價安排測試,而不是讓 E2E 變慢又不可信。